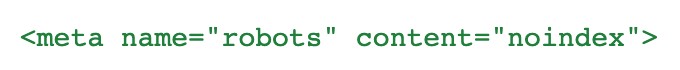
Noindex etiketi, bir sayfanın arama motoru indeksine eklenmemesi gerektiğini açıkça bildirir. HTML sayfalarda <meta name="robots" content="noindex"> ile, HTML olmayan dosyalarda ise X-Robots-Tag başlığıyla verilebilir. Robots.txt'ten farklı olarak, crawler'ın etiketi okuyabilmesi için sayfaya ulaşabilmesi gerekir.
İç arama sonuçları, teşekkür ya da onay sayfaları, staging içerikleri, yinelenen sürümler ve organik aramada bulunmasının anlamı olmayan yardımcı sayfalar noindex için yaygın örneklerdir. Buradaki sık hata, sayfayı robots.txt ile engelleyip noindex'in çalışmasını beklemektir. Crawler URL'yi çekemiyorsa etiketi de okuyamaz. Amaç "arama sonuçlarında görünmesin" ise doğru araç noindex'tir; amaç "tarama bütçesi burada harcanmasın" ise robots.txt farklı bir iş görür.
Noindex uygulanmış bir URL'nin sonuçlardan kaybolması anlık olmayabilir; Google'ın sayfayı yeniden tarayıp direktifi görmesi gerekir. Bu nedenle kritik bir sayfada noindex kullanmadan önce URL Inspection ile mevcut indeks durumunu kontrol etmek, uygulamadan sonra da crawler'ın etiketi gerçekten gördüğünü doğrulamak gerekir. Yanlışlıkla önemli bir sayfaya eklenen noindex, iyi içerik ve güçlü backlink olsa bile o sayfanın organik görünürlüğünü tamamen kesebilir.